Release: Claude Sonnet 5.5 – alle Infos zu Preis, Benchmarks und Einordnung
Anthropic hat am 28. September 2026 Claude Sonnet 5.5 veröffentlicht (claude-sonnet-5-5), knapp eine Woche nach Claude Opus 5.5. Die Kurzfassung: die Mittelklasse-Linie rückt in vielen Benchmarks dicht an Opus 5.5 heran, zum alten Sonnet-Preis von 2 / 10 $ pro Mio. Token. Anthropic positioniert es als die schnellere, günstigere Ergänzung zum Spitzenmodell.
Sonnet 5.5 läuft bereits in boostN
Ich habe Sonnet 5.5 direkt nach dem Release in boostN.ai eingebunden. Der ausführliche Vergleich mit Claude Opus 5.5 und GPT-6.1 Sol läuft gerade, die Ergebnisse folgen in den nächsten Tagen hier und auf LinkedIn. Diesen Artikel hat Claude Opus 4.8 geschrieben, auf Basis der unten verlinkten Quellen.
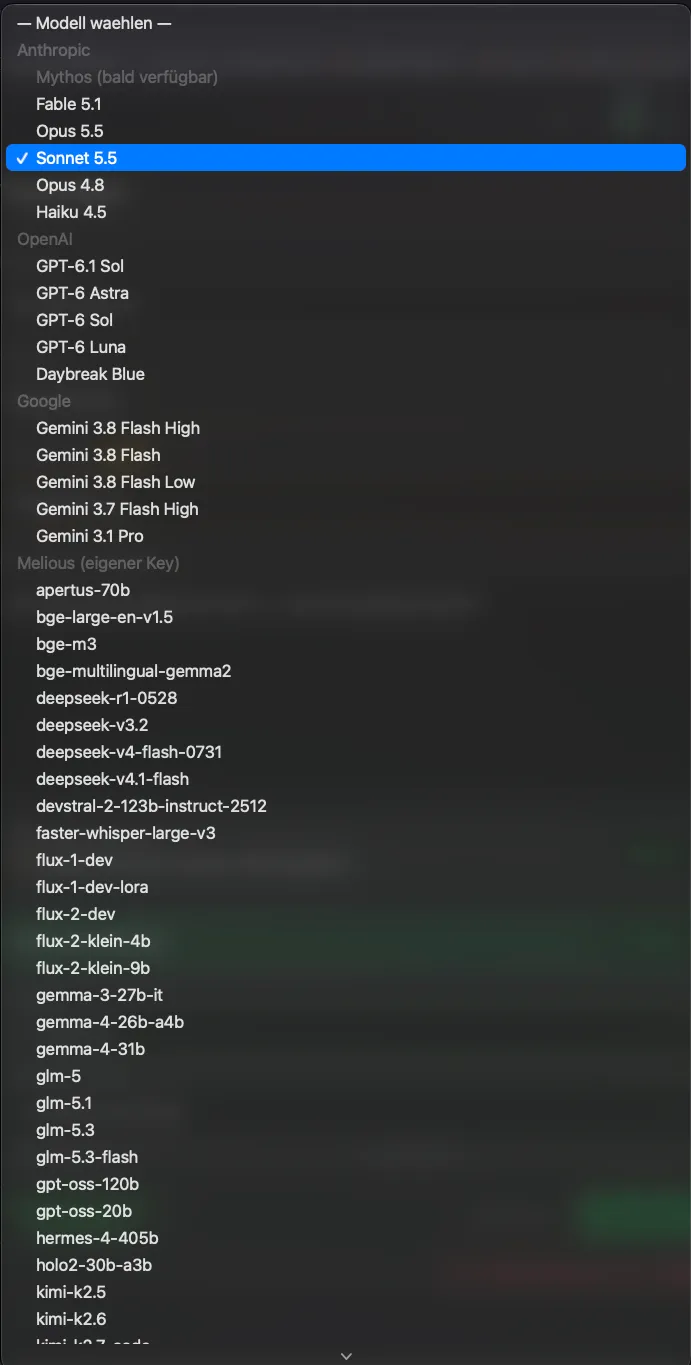
Claude Sonnet 5.5 in der Modellauswahl von boostN, direkt neben Opus 5.5, Fable 5.1 und GPT-6.1 Sol.
Die Fakten
- Preis: 2 $ pro Mio. Input-Token, 10 $ pro Mio. Output-Token, Cache Read 0,20 $, Cache Write 2,50 $ (5 min), Batch 1 / 5 $. Das ist derselbe Listenpreis wie beim Vorgänger Sonnet 5. Opus 5.5 kostet 4 / 20 $, GPT-6.1 Sol liegt mit 2 / 10 $ gleichauf.
- Effizienz: Anthropic nennt bis zu 30 % geringere Kosten pro Task durch weniger verbrauchte Token (Spanne 12–75 % je nach Workload) und über 30 % mehr Tempo als Sonnet 5.
- Kontext: 1 Mio. Token Input, bis zu 128.000 Token Output (im Batch bis 300.000 mit Beta-Header). Das Cache-Minimum sinkt auf 512 statt 1.024 Token.
- Reasoning-Effort: low, medium, high, xhigh, max. Der API-Default ist high, in Claude Code und den Apps ist es medium. Thinking ist standardmäßig an und lässt sich nur über
{"type":"between_tools"}bis Effort high reduzieren. - Zugang: über die Claude API als
claude-sonnet-5-5, dazu Google Cloud, Microsoft Foundry und AWS Bedrock (anthropic.claude-sonnet-5-5), außerdem OpenRouter, Vercel AI Gateway und GitHub Copilot. In Claude Code läuft es über den Aliassonnet. Knowledge Cutoff Juni 2026.
Benchmarks
Alle Werte sind Anthropic-Angaben bei max-Effort. Zum Einordnen stehen Sonnet 5 und Opus 5.5 daneben.
| Benchmark | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | | --- | --- | --- | --- | | Terminal-Bench 4.0 | 70,6 % | 10,3 % | 66,4 % | | FrontierCode 1.1 (xhigh) | 52,1 % | 42,4 % | 54,4 % | | CursorBench 4.0 | 55,5 % | 34,1 % | 57,8 % | | GDPval-AA v2.1 (Elo) | 1844 | 1449 | 1846 | | AA-Briefcase v1.1 (Elo) | 1811 | 1359 | 1822 | | Humanity’s Last Exam (Tools) | 64,5 % | 54,9 % | 67,7 % | | OSWorld 2.1 | 80,1 % | 57,0 % | 81,8 % | | Chartography (ohne Tools) | 61,6 % | 15,6 % | 64,4 % |
Opus 5.5 liegt in 7 der 8 Benchmarks vorn, Sonnet 5.5 schlägt es nur bei Terminal-Bench 4.0. Der Sprung gegenüber Sonnet 5 ist dafür deutlich. Unabhängig davon landet Sonnet 5.5 im Artificial Analysis Intelligence Index bei 56 und schlägt damit GPT-6 Astra (53) und GPT-6.1 Sol (52), bleibt aber hinter Opus 5.5 (58).
Meine Einordnung
Die Headline-Werte sind echt, aber sie gelten nur bei max-Effort, und das ist teuer. Terminal-Bench 4.0 zeigt es am klarsten: die beworbenen 70,6 % kosten rund 12,54 $ pro Versuch. Der API-Default high kommt im selben Benchmark auf 43,0 % zu 1,94 $, der Claude-Code-Default medium nur auf 28,8 %. Wer die Prospekt-Zahlen erwartet, muss den Effort-Hebel bewusst auf max drehen und den Preis dafür einplanen.
Dazu kommen fünf Breaking Changes gegenüber Sonnet 5, die ältere Integrationen mit einem 400-Fehler stoppen können:
thinking {"type":"disabled"}ist weg, ersetzt durch{"type":"between_tools"}(greift nicht bei xhigh/max); Thinking-Budgets entfallen.- Erzwungene Tool-Wahl (
tool_choiceany/tool) wird zuautoplusstrict: true. - Nicht-Default-Werte bei Sampling-Parametern (temperature, top_p, top_k) zusammen mit Assistant-Prefill lösen einen 400 aus.
- Computer Use läuft nur noch mit
computer_toolset_20260801. - Das Advisor-Tool gibt es nur noch mit Opus 5/5.5, Sonnet 5.5, Fable 5/5.1 und Mythos 5/5.1, nicht mehr mit Sonnet 5 oder Opus 4.8.
Für mich ist Sonnet 5.5 die naheliegende Arbeitslinie: fast Opus-Niveau zum halben Preis, spürbar schneller, und mit den Cyber-Fallbacks das erste sicherheitsbewusstere Sonnet. Ob das meine echten Tasks trägt, prüfe ich im direkten Vergleich mit Opus 5.5 und GPT-6.1 Sol. Details zum Modell im Glossar und im Lexikon.